Coleta e Limpeza de Dados: A Base de Toda Análise Confiável
Quando pensamos em análise de dados, é comum imaginar dashboards interativos, gráficos sofisticados e modelos preditivos. No entanto, antes que qualquer insight seja gerado, existe uma etapa fundamental que determina a qualidade de todo o trabalho posterior: a coleta e a limpeza dos dados.
Não importa quão avançadas sejam as ferramentas utilizadas. Se os dados de origem estiverem incompletos, inconsistentes ou incorretos, as análises produzidas terão pouca confiabilidade. Por isso, profissionais de Business Intelligence, Analytics e Ciência de Dados costumam dedicar uma parcela significativa do tempo preparando os dados antes de iniciar qualquer análise.
O que é coleta de dados?
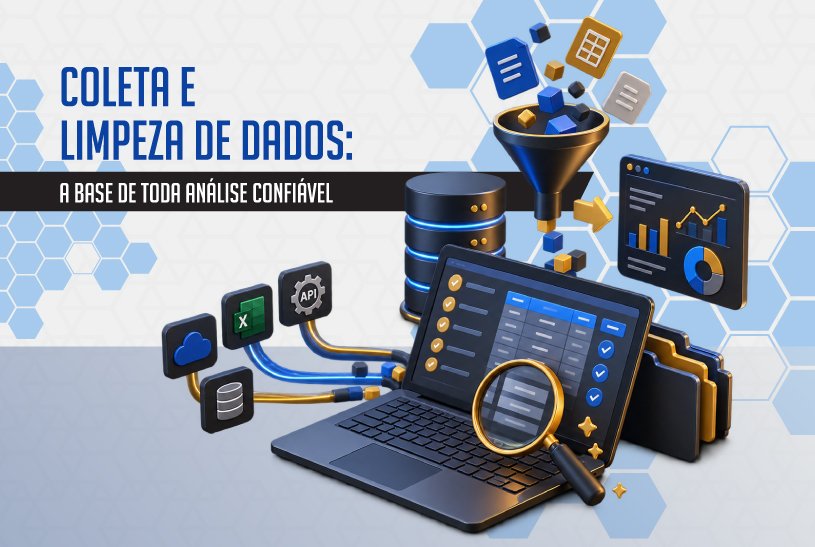
A coleta de dados é o processo de obtenção das informações que serão utilizadas em análises, relatórios ou modelos analíticos. Esses dados podem ser provenientes de diversas fontes, como:
-
Sistemas ERP e CRM;
-
Bancos de dados corporativos;
-
Planilhas Excel;
-
APIs;
-
Ferramentas de marketing digital;
-
Redes sociais;
-
Sensores e dispositivos IoT;
-
Bases públicas disponibilizadas por órgãos governamentais.
O objetivo dessa etapa é reunir informações relevantes, atualizadas e consistentes para responder a uma necessidade de negócio específica.
Por exemplo, uma empresa que deseja analisar o desempenho de vendas pode coletar dados de pedidos, clientes, produtos e campanhas de marketing para entender quais fatores influenciam seus resultados.
Os principais desafios da coleta de dados
Na prática, a coleta de dados raramente ocorre de forma perfeita. É comum encontrar problemas como:
Dados dispersos
As informações podem estar armazenadas em diferentes sistemas que não se comunicam entre si.
Falta de padronização
Datas, moedas, categorias e identificadores podem seguir padrões distintos dependendo da origem dos dados.
Registros incompletos
Campos importantes podem estar vazios ou preenchidos de forma incorreta.
Atualização inconsistente
Nem sempre as bases são atualizadas na mesma frequência, o que pode gerar divergências entre relatórios.
Esses problemas tornam indispensável uma etapa posterior de preparação dos dados.
O que é limpeza de dados?
A limpeza de dados, também conhecida como Data Cleaning, consiste no conjunto de técnicas utilizadas para identificar e corrigir problemas presentes em uma base de dados.
Seu objetivo é garantir que os dados sejam confiáveis, consistentes e adequados para análise.
Durante esse processo, são realizadas atividades como:
-
Remoção de registros duplicados;
-
Correção de erros de digitação;
-
Tratamento de valores ausentes;
-
Padronização de formatos;
-
Validação de regras de negócio;
-
Identificação de valores inconsistentes.
Sem essa etapa, as análises podem gerar conclusões equivocadas e comprometer a tomada de decisão.
Problemas comuns encontrados durante a limpeza
Registros duplicados
Um mesmo cliente pode aparecer diversas vezes na base devido a erros de cadastro ou integração entre sistemas.
| ID | Nome |
|---|---|
| 101 | João Silva |
| 101 | João Silva |
Caso não sejam removidos, esses registros podem distorcer métricas como quantidade de clientes ou volume de vendas.
Valores ausentes
Campos vazios são extremamente comuns.
| Cliente | Cidade |
|---|---|
| Maria | São Paulo |
| Carlos | NULL |
Dependendo do contexto, esses registros podem ser preenchidos, removidos ou tratados separadamente.
Formatos inconsistentes
Uma mesma informação pode ser registrada de diferentes formas.
-
01/08/2026
-
2026-08-01
-
01-08-2026
Embora representem a mesma data, sistemas analíticos podem interpretá-las de maneiras diferentes.
Erros de digitação
Pequenos erros podem gerar categorias distintas para o mesmo valor.
-
São Paulo
-
Sao Paulo
-
SP Capital
Sem padronização, relatórios podem apresentar resultados incorretos.
Etapas de um processo de preparação de dados
Uma abordagem comum para preparação de dados segue as seguintes etapas:
1. Extração
Obtenção dos dados a partir das fontes de origem.
2. Validação
Verificação inicial para identificar erros, campos ausentes e inconsistências.
3. Transformação
Padronização dos dados conforme regras definidas.
4. Limpeza
Correção dos problemas identificados.
5. Enriquecimento
Inclusão de informações adicionais que agreguem valor à análise.
6. Carregamento
Disponibilização dos dados para ferramentas analíticas, bancos de dados ou dashboards.
Esse fluxo é frequentemente conhecido como ETL (Extract, Transform, Load) ou ELT (Extract, Load, Transform).
Ferramentas utilizadas para coleta e limpeza de dados
Existem diversas ferramentas capazes de auxiliar nesse processo.
Excel
Muito utilizado para bases menores e análises rápidas.
SQL
Permite consultar, transformar e validar grandes volumes de dados diretamente em bancos relacionais.
Python
Bibliotecas como Pandas e Polars oferecem recursos avançados para manipulação e limpeza de dados.
Power Query
Ferramenta presente no Excel e Power BI que permite criar fluxos de transformação sem necessidade de programação avançada.
dbt
Amplamente utilizado em projetos modernos de engenharia e transformação de dados.
Boas práticas para garantir qualidade dos dados
Algumas práticas ajudam a reduzir problemas e aumentar a confiabilidade das análises:
-
Definir padrões de preenchimento desde a origem;
-
Automatizar validações sempre que possível;
-
Documentar regras de negócio;
-
Monitorar indicadores de qualidade dos dados;
-
Realizar auditorias periódicas;
-
Manter processos de atualização bem definidos.
Quanto mais cedo os problemas forem identificados, menor será o custo de correção.
Conclusão
A qualidade de uma análise depende diretamente da qualidade dos dados utilizados. Por isso, coleta e limpeza de dados não devem ser vistas como etapas secundárias, mas como parte essencial de qualquer projeto de Business Intelligence, Analytics ou Ciência de Dados.
Investir tempo na obtenção de dados confiáveis, consistentes e bem estruturados reduz erros, aumenta a precisão dos relatórios e permite que decisões sejam tomadas com muito mais segurança.
Antes de construir dashboards ou aplicar modelos avançados de análise, vale lembrar uma regra simples: dados de qualidade são o primeiro passo para gerar insights de qualidade.
Vamos transformar dados em resultados?
Estou aberto a oportunidades como Analista de Dados, BI Analyst e projetos de consultoria.